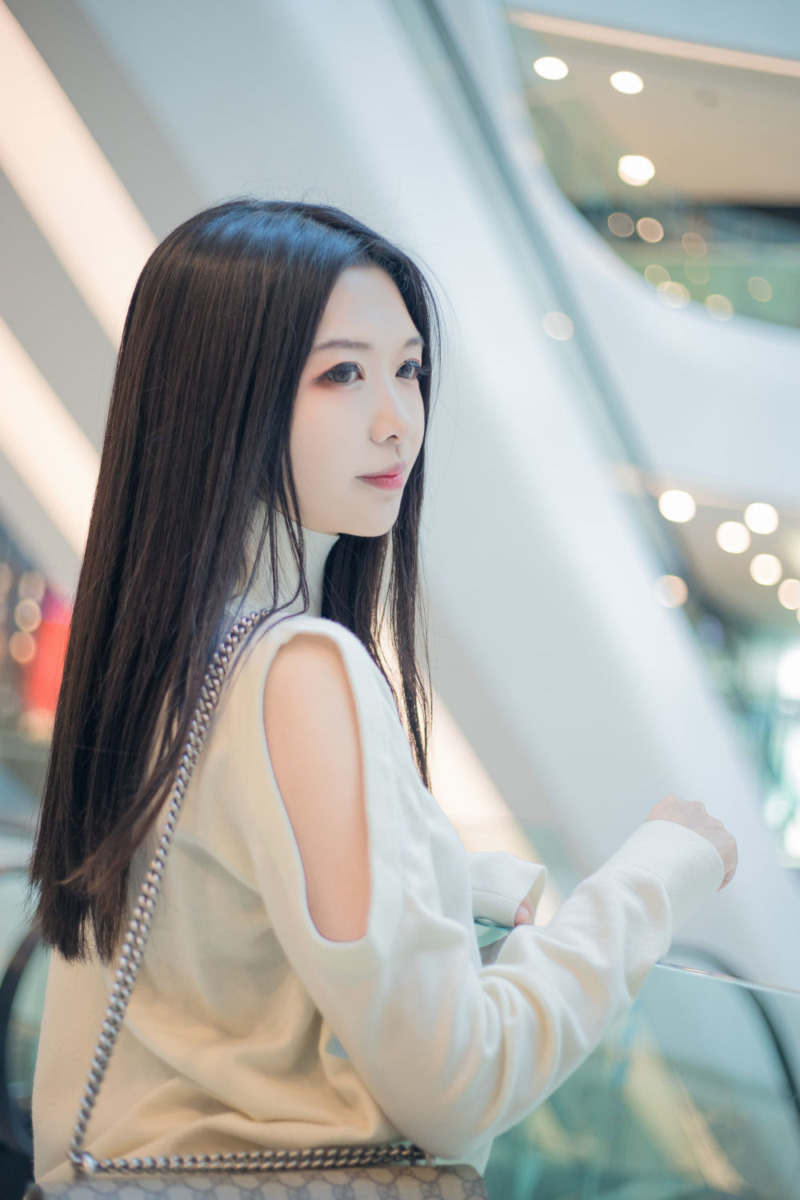
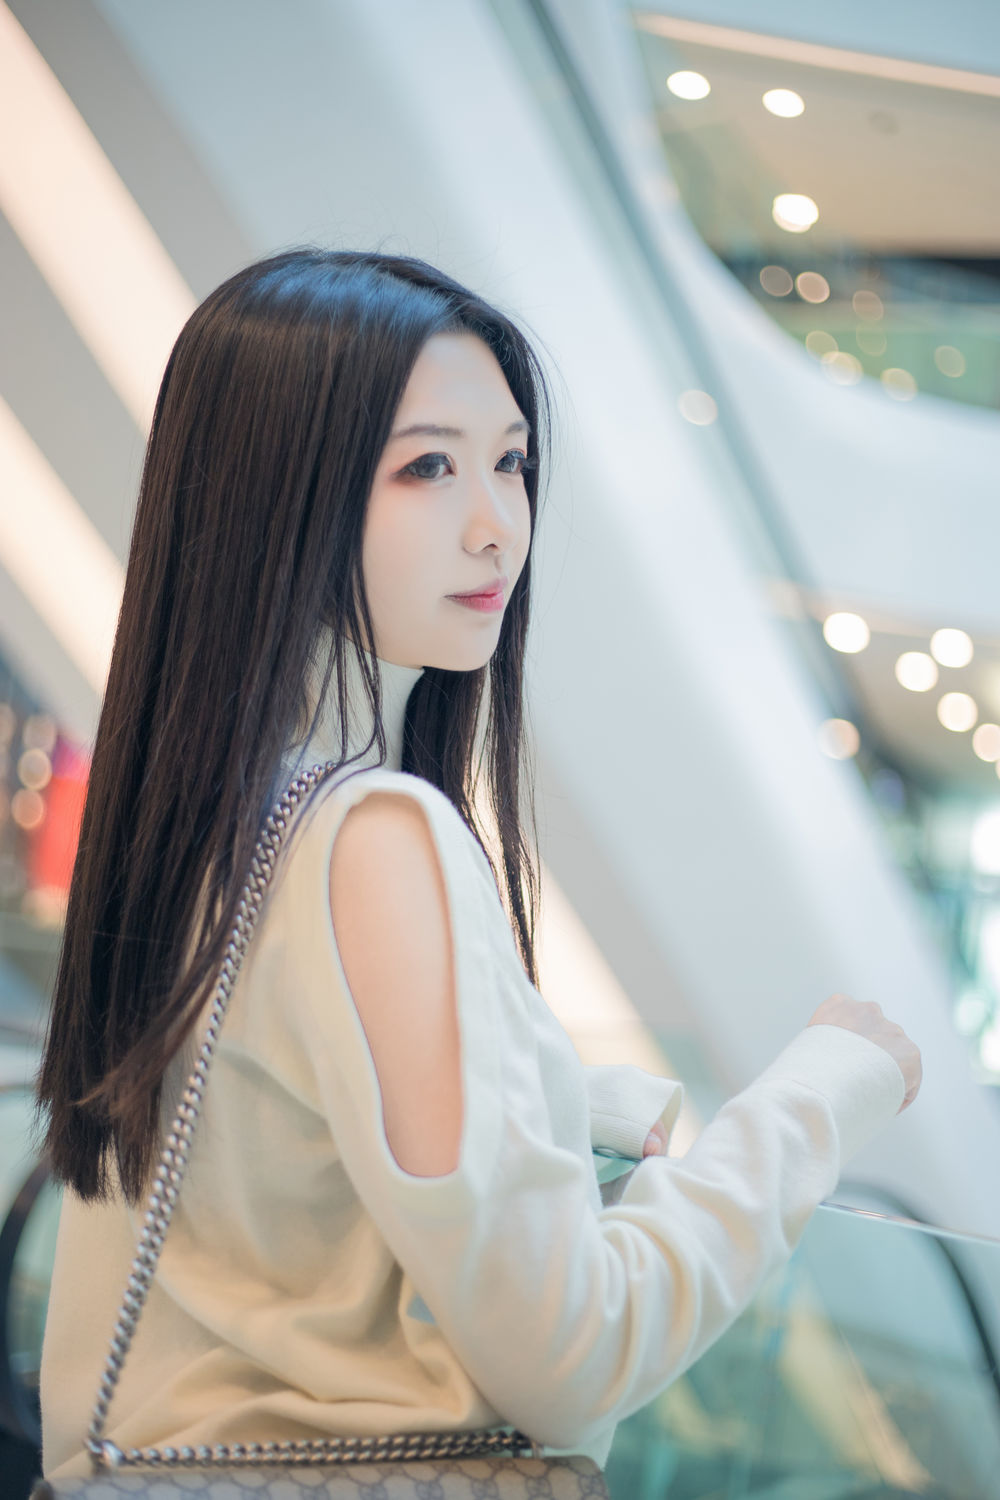
源纱希喵喵喵靠在商场的玻璃栏杆边回头,人和环境之间隔着一段轻松的距离;换上黑蓝赛车服、坐进金属管线围出的窄景后,视线和动作一下子收紧了。日常装和赛车造型的差别,与其说在衣服,不如说在人怎样占据空间,先看清这一点,再去分题材。
车旁画面有动势,也可能只是静帧
车门打开、头发扬起,很容易让人把“有动感”直接等同于“有视频”。这两件事没有必然联系。一张照片可以冻结行动中的一瞬,斜线构图也能制造移动感;视频则需要真实存在的连续画面。光看封面,既看不出片段多长、有几个镜头,也看不出照片和视频是不是同一次拍摄。
图片和视频传递的信息本来就不同。照片可以一张张停下来看,视频里的动作要经过起势、转折和停顿。时装展示片段可能围绕一个动作展开,拍摄花絮则可能记录灯具调整和现场交流,扩展名一样,内容可以完全是两回事。
体积同样替内容作不了证。时长更长通常意味着更多数据,但编码方式、画面复杂度和压缩设置都会改变结果。静止背景前缓慢转头,和满画面细碎反光的运动场景,对编码的要求差得很远,“文件更大,细节一定更多”这个推断少了太多前提。
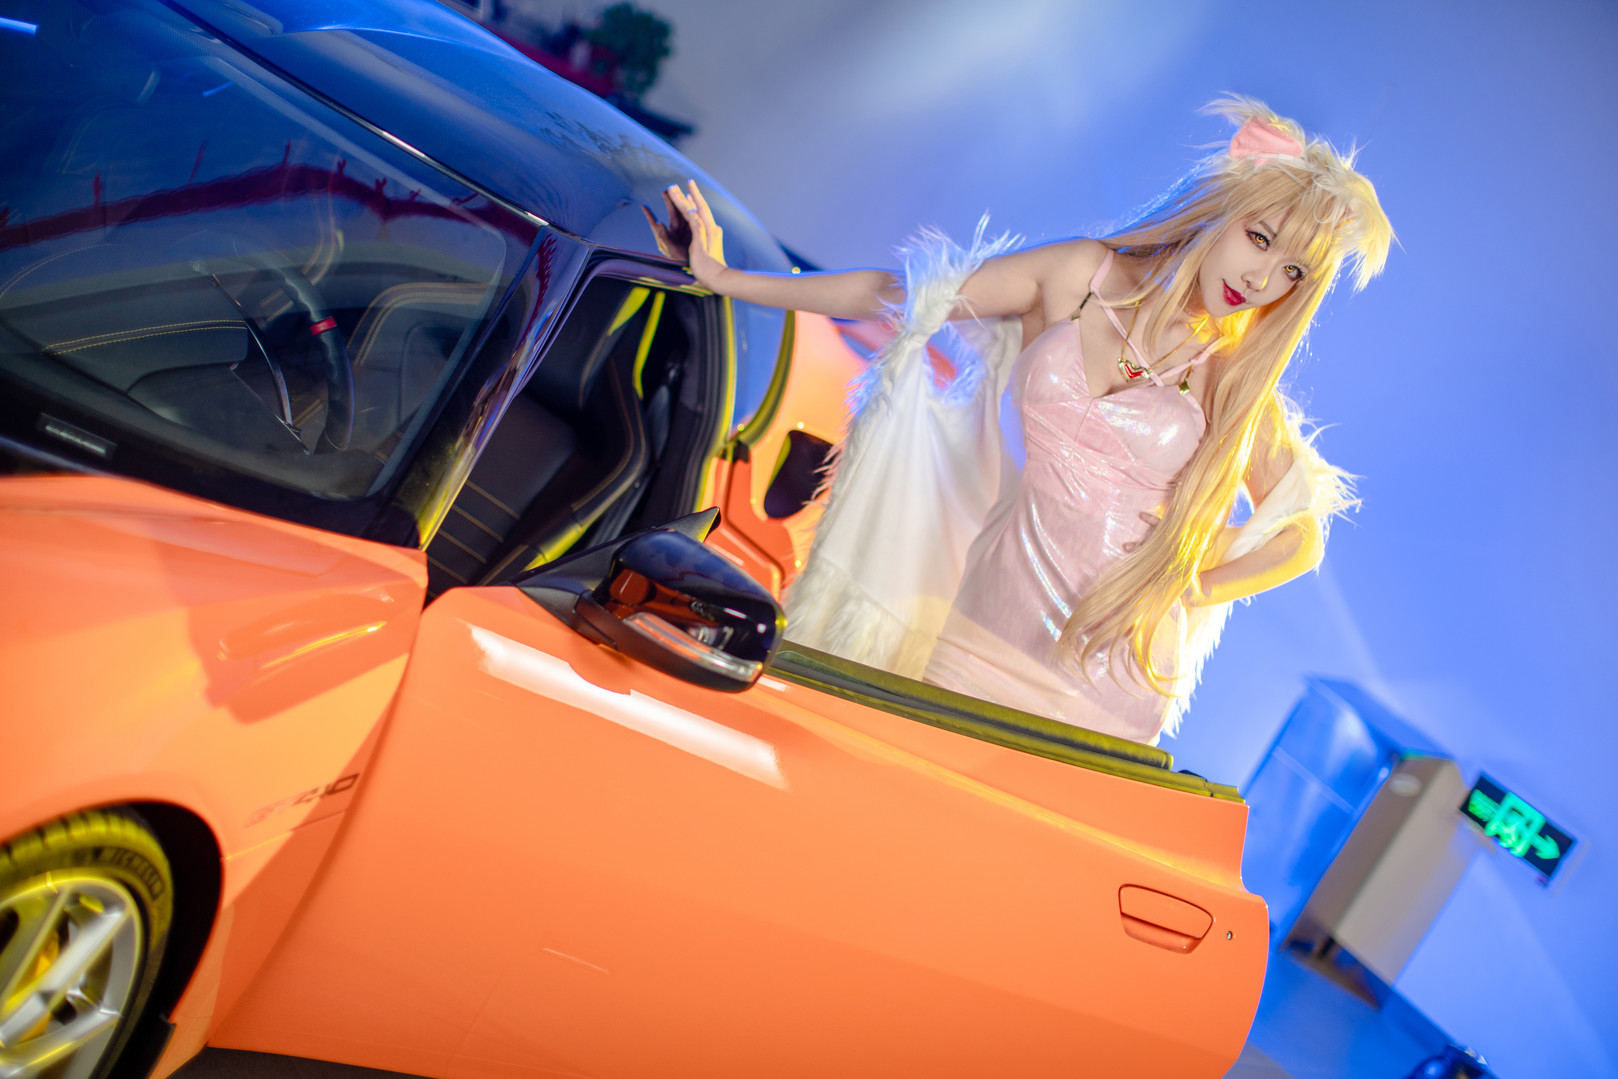
源纱希喵喵喵的清单里确实有带视频的条目,但没有时长和编码参数,所以这里不谈具体视频的质量。若要把车旁这张静帧改成动态,最该提前设计的是人物和车门的运动范围:开门、转身、长发甩过的位置,要在连续时间里互相让开。
一次上新,未必等于一次完整拍摄
打开创作者页面,帖子按发布时间排得整整齐齐,看上去像一条完整的生产线。拍摄和交付却未必同步。一批照片可以分几次放出,同一主题的近景和全身照也可以拆进不同帖子,发布日期只说明公开的时间,不等于按下快门的日期。
平台工具本身就体现了这种分离。Patreon用合集来组织帖子,可以围绕一个主题重新编排;FANBOX则以创作者持续提供内容来建立支持关系。作品、帖子和订阅周期三者不再天然对齐,拿其中一个单位的变化去解释拍摄产量,结论多半是错的。
编辑藏在背后的活儿,是处理重复信息。远景已经把服装和布景交代清楚了,下一张近景最好补上表情、材质或动作细节。只把同一姿势换个裁切,拿来做社交平台封面没问题,放进连续阅读的一组图里就显得多余。
这也解释了同一个人为什么能有几种差别很大的呈现:日常环境可以顺着细微表情一路展开,角色专题则先交代识别物,再处理场景关系。站内水淼的角色场景也适合拿来对照,比较时看构图在承担什么任务,别把页面的发布时间拼成一段拍摄经历。
白色上衣退后,蓝色礼服走到前面
玻璃栏杆旁,白色上衣和浅色建筑几乎融在一起,是深色长发给人物留下了一条完整的边。包的链条往下垂,身体轻轻靠着栏杆,画面里没有哪件道具需要被刻意展示。环境留出大片空白,注意力自然落在回望的表情上。
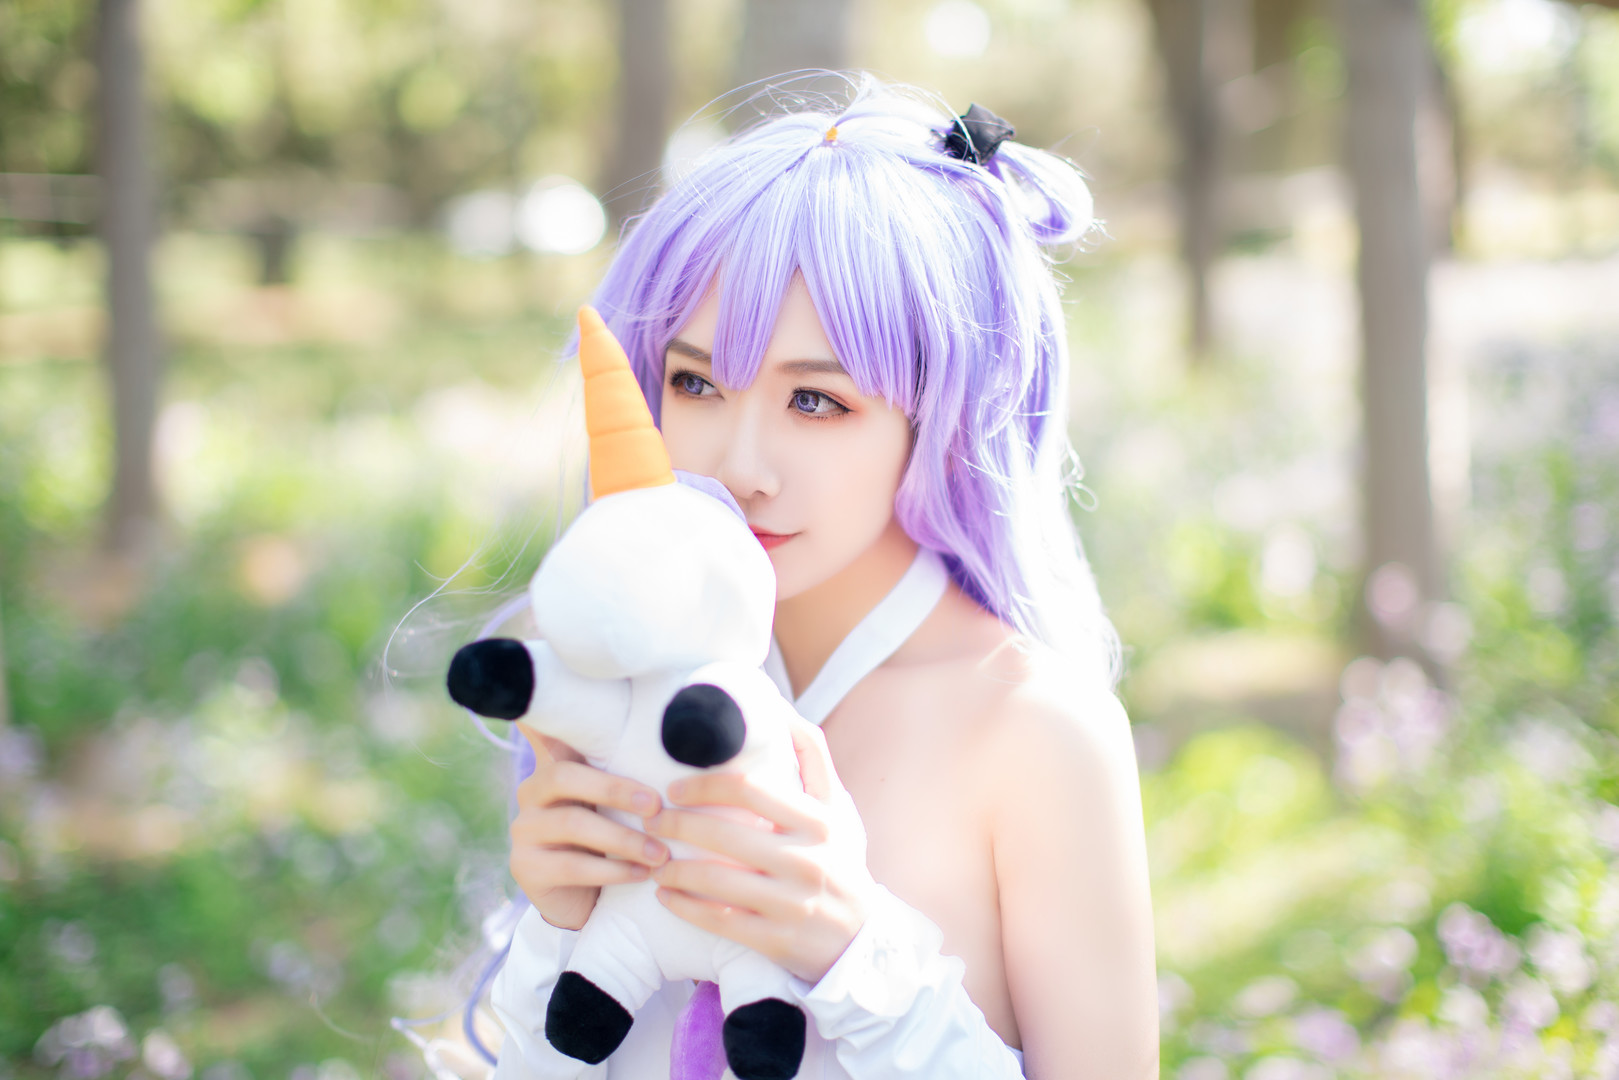
户外那张把白色独角兽玩偶举到脸旁。紫色长发、虚化的绿色背景和玩偶上那点黄色的角,构成一组清楚的颜色关系,双手也因为拿着东西有了自然的落点。
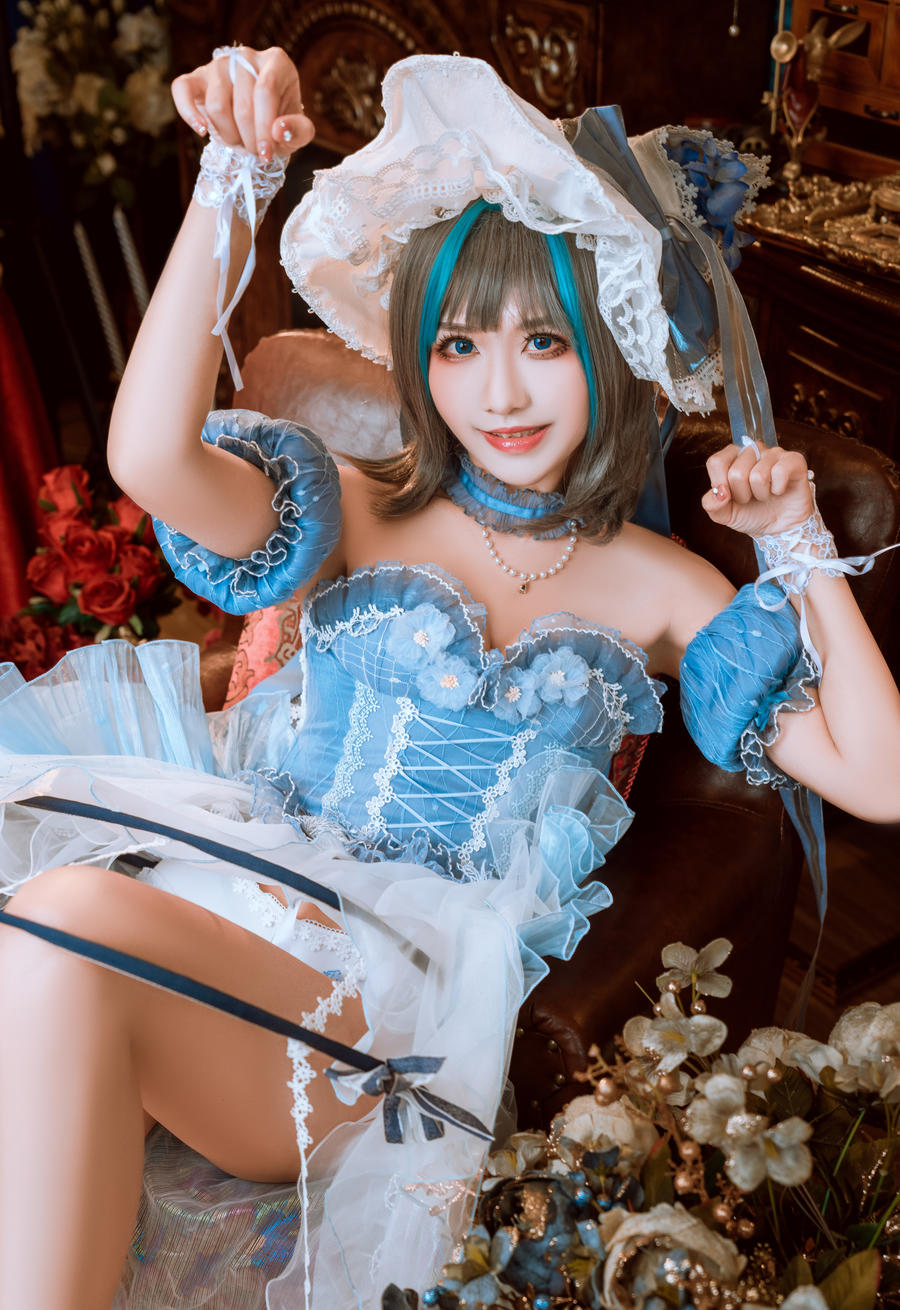
蓝白蕾丝裙装的室内图,密度完全换了一档。宽沿帽、蕾丝、蝴蝶结和袖口装饰都贴着人物,深色沙发垫在后面,浅色细节从里面浮出来。它和商场照片的区别不只是“装饰多”和“装饰少”,而是视线要在画面里停几次,才能重新落回眼睛。
冷蓝灯光的返工,往往从肤色开始
橙色车身旁打一道蓝光,车和背景立刻分开了,脸却未必同时拿到合适的颜色。后期把整张图往暖拉,蓝色背景就弱了;只提亮皮肤,头发和衣服又还压着过重的冷色。一次全局调整解决不了所有区域,返工几乎都发生在这种交界处。
想少返工,拍的时候就得定好分工:人物主光负责让脸保留可读的明暗,环境色光负责建立空间。两者完全混在一起,后期就只能沿着发丝、肩线和衣料边缘一点点区分,时间花在修边界上,而不是多挪一下某个滑杆。
视频会把这笔成本放大。单张图上准确的选区,碰到转头、发丝飘动或衣褶变化,到下一段画面就不再适用。连续镜头里局部颜色一明一暗,比一张照片轻微偏色显眼得多,所以动作越多,越该在现场拿到稳定的底色,别指望剪辑时逐帧救回来。
自然光也不是完全省事。窗边或商场里的混合照明,常常让靠窗一侧偏冷、顶灯照到的一侧偏暖。这种差异留一部分反而是环境信息,要处理的只是突然断开的色块。
靠栏杆的停顿,不能直接搬进赛车镜头
身体一靠上栏杆,动作就有了外部支撑,手臂可以放松,视线也可以短暂离开镜头。坐进紧凑的金属布景就不一样了:帽沿、衣服边缘和腿的方向都要照顾到,任何一处和背景线条重合,轮廓就会乱。两种情境的镜头感,解决的是两类问题。
日常状态讲究动作有来处。抬手可以是在整理袖口,侧身可以是在看栏杆外面;每个动作都只为了朝向相机,画面就少了生活里的那点连接。角色呈现可以把这些日常过渡压缩掉,把最有识别度的姿态留在镜头里,但压缩不等于全身每一处都绷紧。
拿同一个手势做两次试验就能看出差别:一次让手先找到真实的支点,再带动身体;一次只模仿手指的形状,再勉强去摆肩膀。后一种常见多余的耸肩或前臂扭转,照片会把这份紧张记下来,视频还会记录它是怎么发生的。
摆对姿势和走通动作,是两件事。
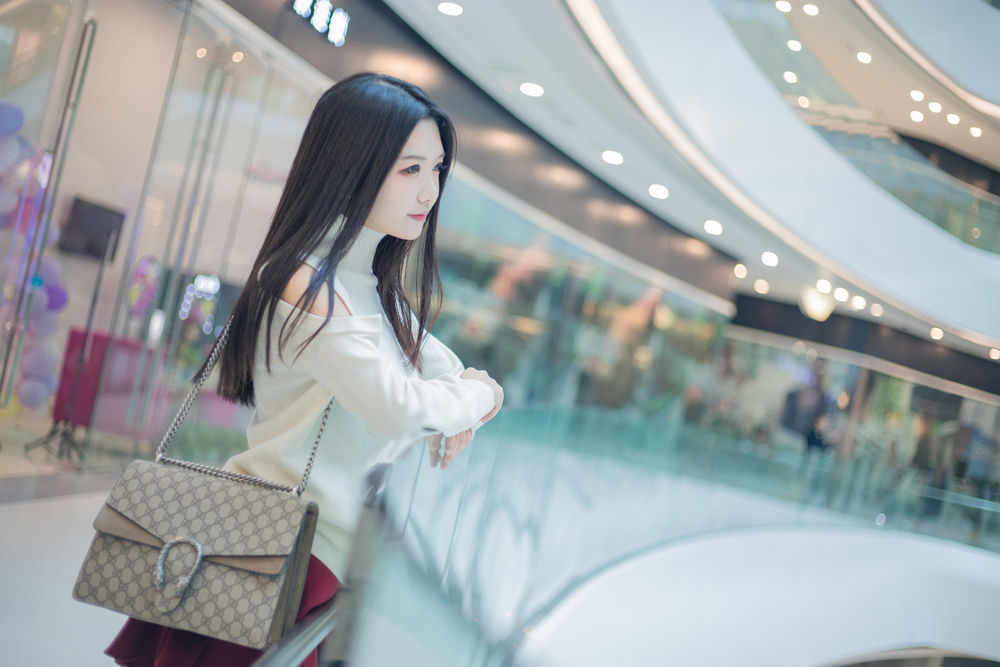
看源纱希喵喵喵这张倚栏的照片,可以把目光从表情移到肘部和栏杆接触的位置,支撑关系在那里一目了然,你也能从这一处学到最多。
赛车服上的文字,先于角色名字被读到
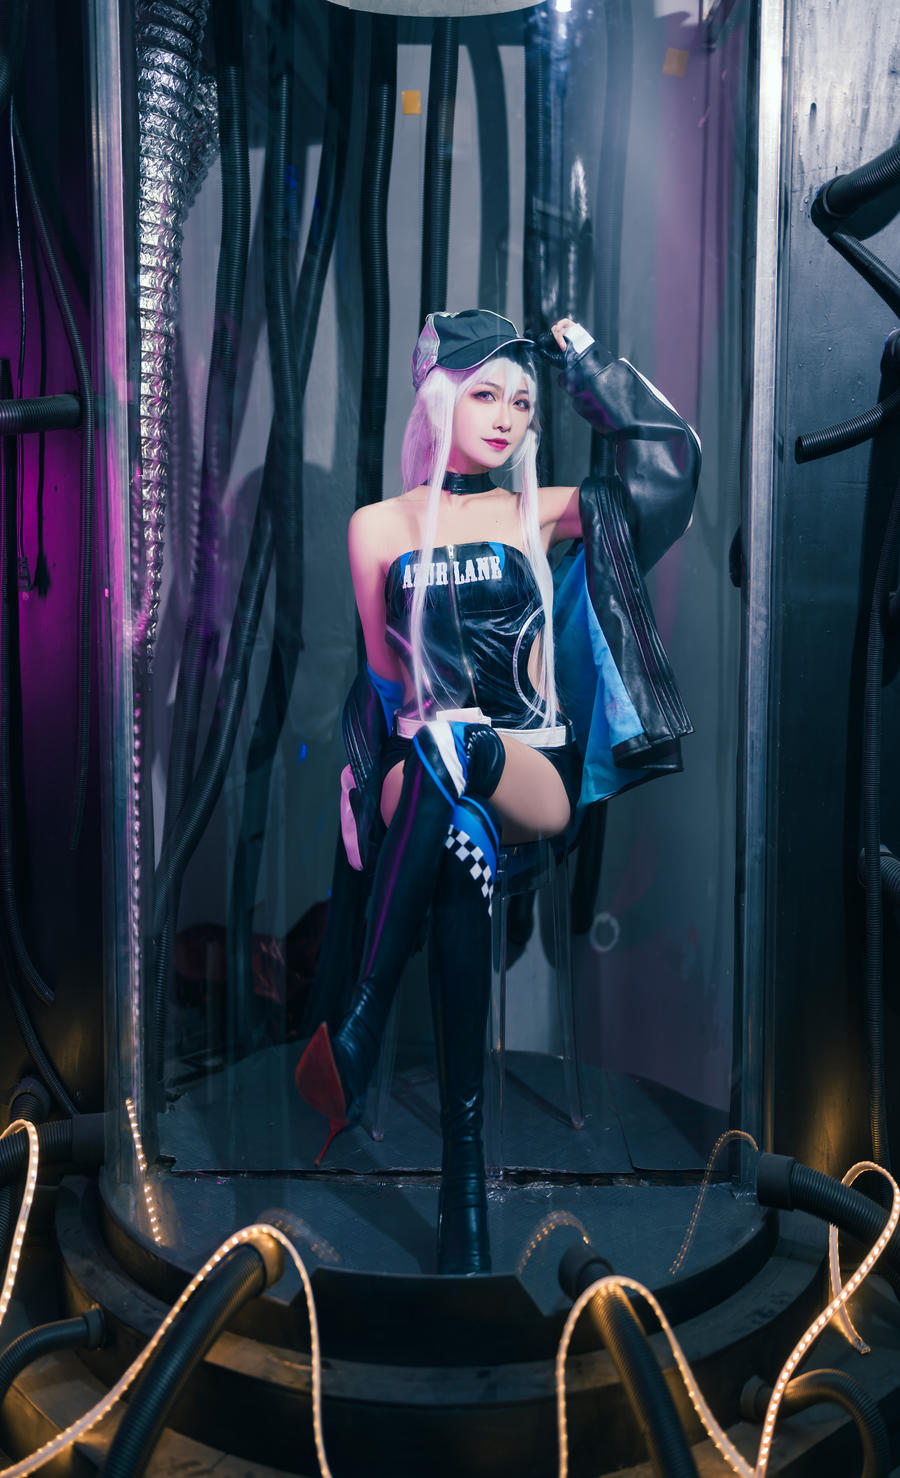
黑蓝服装上的AZUR LANE字样、格纹装饰和帽子,是金属景这张照片里可以直接指认的线索,赛车题材靠它们在视觉上站住了脚。素材标题里另有“碧蓝航线 企业赛车”的条目,不过条目和单张图片之间没有逐一对应的说明,光凭同色长发就下角色结论,还差一步。
游戏官方用“角色名+换装名”来区分形象,同一个角色可以在好几套服装方案里反复出现。拿来做摄影分析时,不妨把识别拆成两层:发型和配饰负责人物的延续,服装字样和主题道具负责版本的方向。只剩一件主题服装,通常还撑不起“还原准确”这个判断。
比较造型时,判据最好能在图上找到。帽饰在不在,领口和主要色块的相对位置对不对,关键道具有没有出现,这些都比“感觉像”好复核。姿势则可以随场景调整,宣传图里那一个固定角度,不是所有摄影构图的唯一答案。
同人设计还可能主动改动服装。改动有说明,就可以讨论它怎么保留识别;没有说明,就停在照片能确认的那一层。站内写真合集按人物汇集图文,它不是游戏的官方设定集,两种信息读的时候也要分开。
金属管线不必还原一条真实赛道
看到赛车造型就去找赛道,是很自然的搭配,但不是唯一的选择。狭窄的管线景可以用冷光、反射和工业材料营造机械感,不必复制真实的赛车场地。只要不把这种布景当成赛场纪实,摄影就有空间去用更抽象的环境关系。
关键在于控制范围。金属表面会反出亮点,管线又拉出许多竖向边缘,一旦它们同时穿过脸、帽子和肩膀,人物就被切碎了。稍微调整坐姿或机位,让背景线条从人物两侧绕过去,比一味加大虚化更能保住工业空间的特点。
转成视频时,画面外的东西也会陆续闯进来。静帧可以把场景边界藏在裁切之外,移动镜头却可能直接拍到接缝、灯架或没处理的角落。先确定能用的运动范围,再设计人物动作,比照搬静态构图可靠得多(照片里成立的空间,不等于一个可以自由走动的场景)。
日常题材也适用同一原则:背景不必处处真实丰富,但画面里已经建立的关系要自洽。清水由乃的车旁和室内照片是另一组场景变化,看的时候留意人物和背景之间的间距,以及机位一变之后还剩下哪些轮廓。